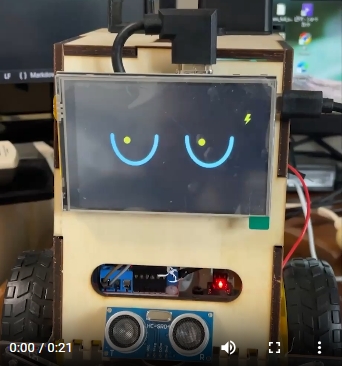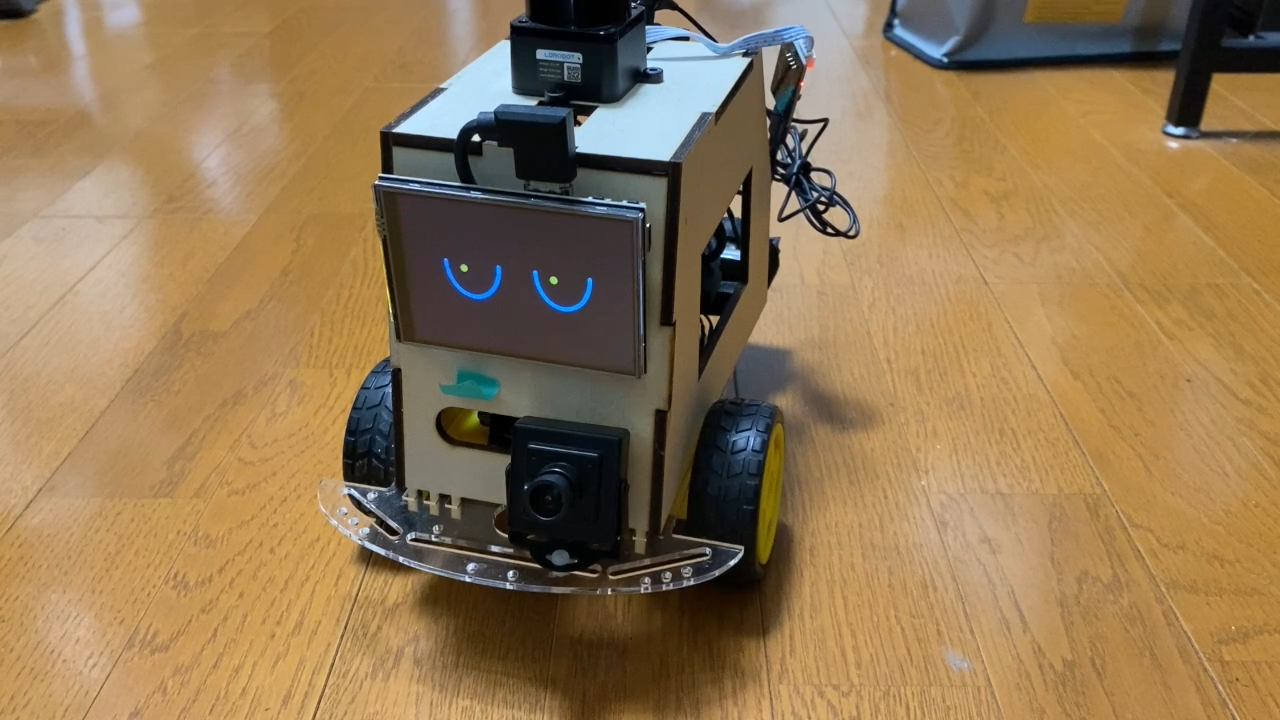
これまで個別に開発してきたモーター制御、顔表示、カメラ、音声対話を一つにまとめ、GUIランチャーから起動できるROS 2ローバーとして動く様になりました。
今回は、現在できるようになったことと、実際の起動から走行までの流れを自分の整理を兼ねて紹介します。
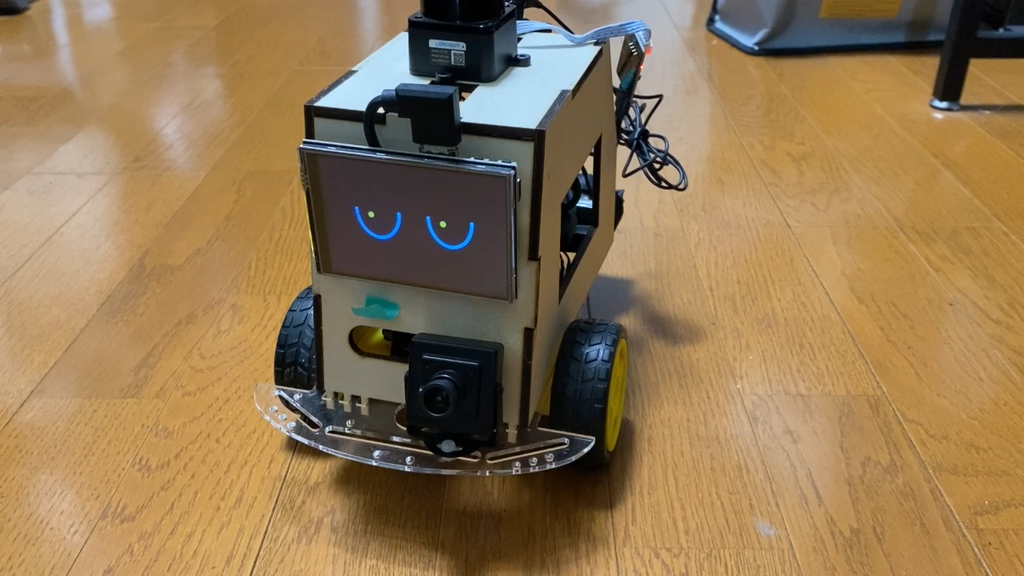
【写真:完成したローバーの全景】
ROS 2で走行・画面・カメラを制御し、ローカルLLMで音声対話するAIチャットローバー。
【動画:完成機能のダイジェスト】
今回できるようになったこと
現在のローバーでは、次の機能を一通り動かせるようになりました。
- GUIランチャーによる起動・停止・状態確認
- キーボードまたはUSBジョイスティックによる走行
- Raspberry PiのGPIOを使った左右モーター制御
- 本体画面への顔表示とまばたき
- USBカメラ映像のブラウザー表示
- カメラ映像の本体画面への重畳
- マイク入力、音声認識、ローカルLLM、音声合成による対話
一つひとつの機能を動かすだけなら、個別のコマンドでも起動できます。しかし、複数のPCとRaspberry Piへ接続し、決められた順番でサービスを立ち上げる作業は、毎回行うには少し複雑です。そこで今回、日常的な起動と停止をGUIへまとめました。
ローバー全体の構成
このシステムは、一台のコンピューターですべてを処理する構成ではありません。それぞれが得意な役割を担当し、家庭内ネットワークを介して連携します。
| 機器 | 主な役割 |
|---|---|
| Windows PC (※後述しますがMacに移行) | GUIランチャー、音声認識、音声合成、システム全体の起動管理 |
| Ubuntu PC | キーボード/ジョイスティック入力をROS 2の走行指令へ変換 |
| Raspberry Pi(3B+) | モーター制御、顔画面、マイク、スピーカー、USBカメラ |
| ローカルLLM実行環境 | 認識した会話文に対する応答生成 |
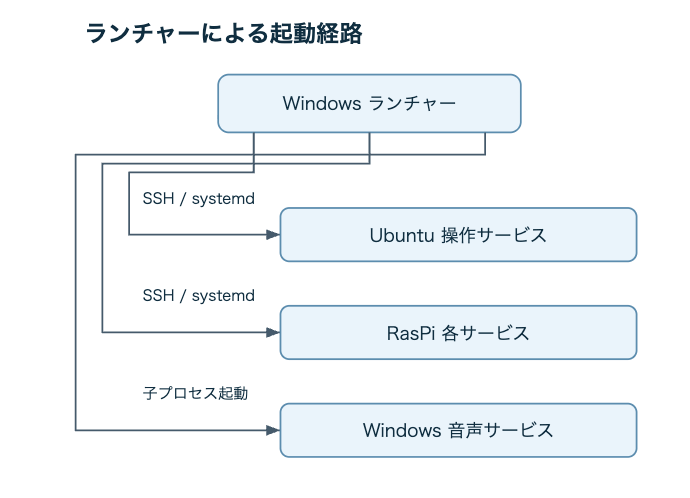
Windowsのランチャーは、各プログラムを起動・停止する管理役です。通常の走行指令やカメラ映像そのものを中継しているわけではありません。走行指令はUbuntu PCからRaspberry Piへ、音声と映像はそれぞれの経路で送られます。
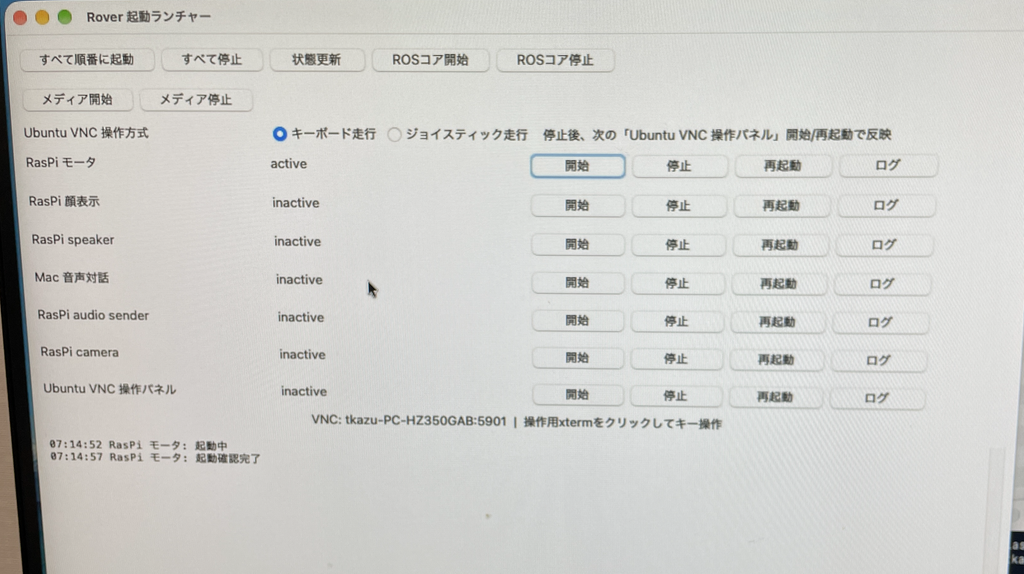
GUIランチャーから起動する
以前は、Windows、Ubuntu PC、Raspberry Piで端末を開き、複数のコマンドを順番に実行していました。現在はWindowsでランチャーを開き、各サービスの状態を確認しながら起動できます。
「すべて順番に起動」を実行すると、ランチャーは次の順序で機能を立ち上げます。
- Raspberry Piのモーター制御
- 顔表示
- スピーカー
- Windowsの音声対話サービス
- Raspberry Piのマイク音声送信
- USBカメラ配信
- Ubuntu PCの操作パネル
音声の受け側を先に準備してから送信側を開始するなど、機能間の依存関係を考えた順序です。途中で起動に失敗した場合は、ランチャーの表示とログから対象を確認できます。
顔表示とカメラ
本体の横長画面には、通常時の顔とまばたきを表示します。操作に応じて表情を切り替えられるほか、USBカメラの画像を顔画面へ重ねることもできます。カメラ映像はブラウザーからも確認できます。Raspberry Piが取得したUSBカメラ映像をネットワークへ配信し、操作用PCのブラウザーで表示します。
ローカルLLMとの音声対話
音声対話では、Raspberry Pi側のマイクから音声を送り、音声認識で文章へ変換します。その文章をローカルLLMへ渡し、生成された返答を音声合成して、ローバー側のスピーカーから再生します。
ここまでで、個別に作ってきた機能を一つのシステムとしてまとめ、GUIから起動して実際に操作できるところまでを紹介しました。
- Windowsのランチャーから各機能を順番に起動できる
- 顔表示、カメラ、音声対話、モーター走行を一通り利用できる
- 複数の機器へ役割を分け、ROS 2とネットワークで連携している
ただし、実際に会話させてみると、ローカルLLMの返答を待つ時間が遅く気楽に会話するというわけにはいきませんでした。(待つときは長い時で10秒くらいのときもありました。)
機能として動くだけでなく、ローバーとの会話をもっと自然にするには、LLMを動かす環境の見直しが必要です。
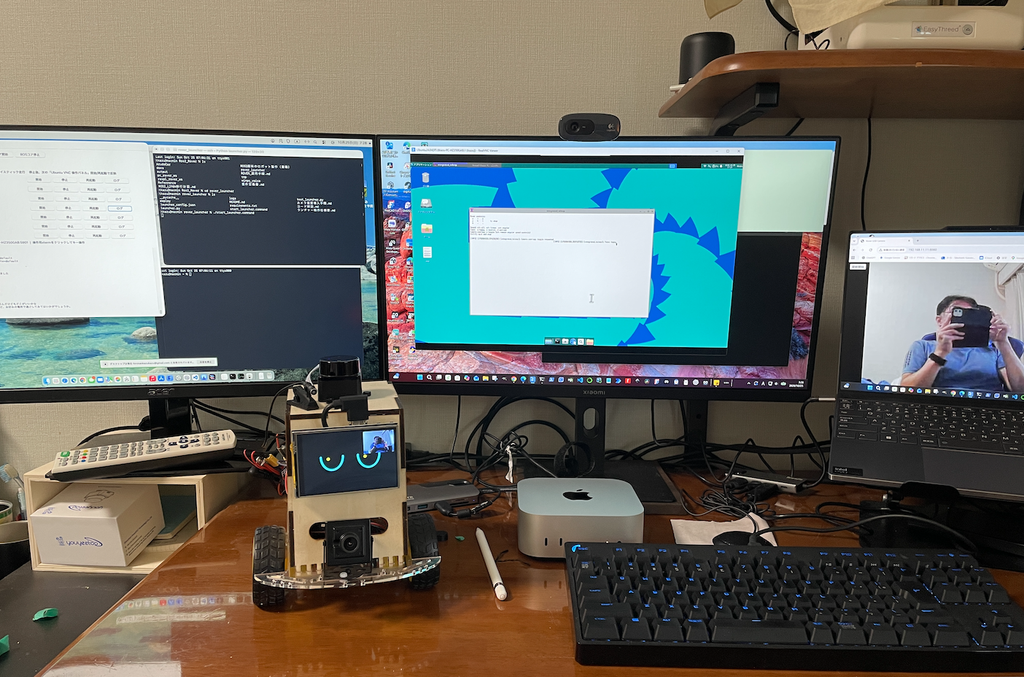
そこで、Windows中心だった音声認識・合成・LLMの処理を、Mac miniで処理するようにしました。
Mac miniをローカルLLM用に追加する
そこで、ローカルLLMの実行先としてMac miniを導入しました。自宅ネットワーク上のMac miniにてLLM処理を実行します。
CPU : M6 (RAM: 32GB, SSD:512GB)
STT : Whisper Small(当初) => Apple 標準のSTTを採用(音声認識の精度が秀逸です)
LLM : Gemma3: 12b_Q4_K_M
TTS : Mac標準(say)
モーター制御やカメラなどの実機処理は従来どおりRaspberry Piが担当します。UbuntuへのVNC接続など、必要な範囲で既存構成を利用します。
Macでは、STT=>LLM=>TTSまでの処理すべて任せました。これで発話完了から応答までで1〜3秒程度になりました。もう少し改善したいところもありますが実用的にはなったと思います。
今回のまとめ
- Windows中心の構成で、音声対話の一連の流れを先に完成させた
- 実際に使うと、LLMの応答の時間が課題になった
- Mac miniへ音声、LLM処理を移し、既存の実機制御を大きく変えずに改善を試し効果を確認した
次回は、手動で操作するローバーから一歩進み、いよいよLiDARとROS 2シミュレーションを使った自律走行への取り組みを紹介できたらと思います。